本文是 unit_rc 系列第二篇,基于 2.10.0 源码快照。上一篇见《用 C++ 把 N×N 跨语言桥接降为 N×1》。
代码生成器常被误解成“读取配置,然后替换模板变量”。如果输入只是几个方法名,这样做足够;但 .ur 已经包含接口、继承、方法修饰、空值、容器、回调、Protobuf、平台方向和默认参数,它本质上是一门小型 DSL。
urgen 因而采用了接近编译器的分层:
.ur source
   │
   ▼
parser / AST
   │
   ▼
semantic model
   │
   ▼
language backends + templates
   │
   ▼
C++ / Kotlin+JNI / ObjC / Dart+FFI / ArkTS+N-API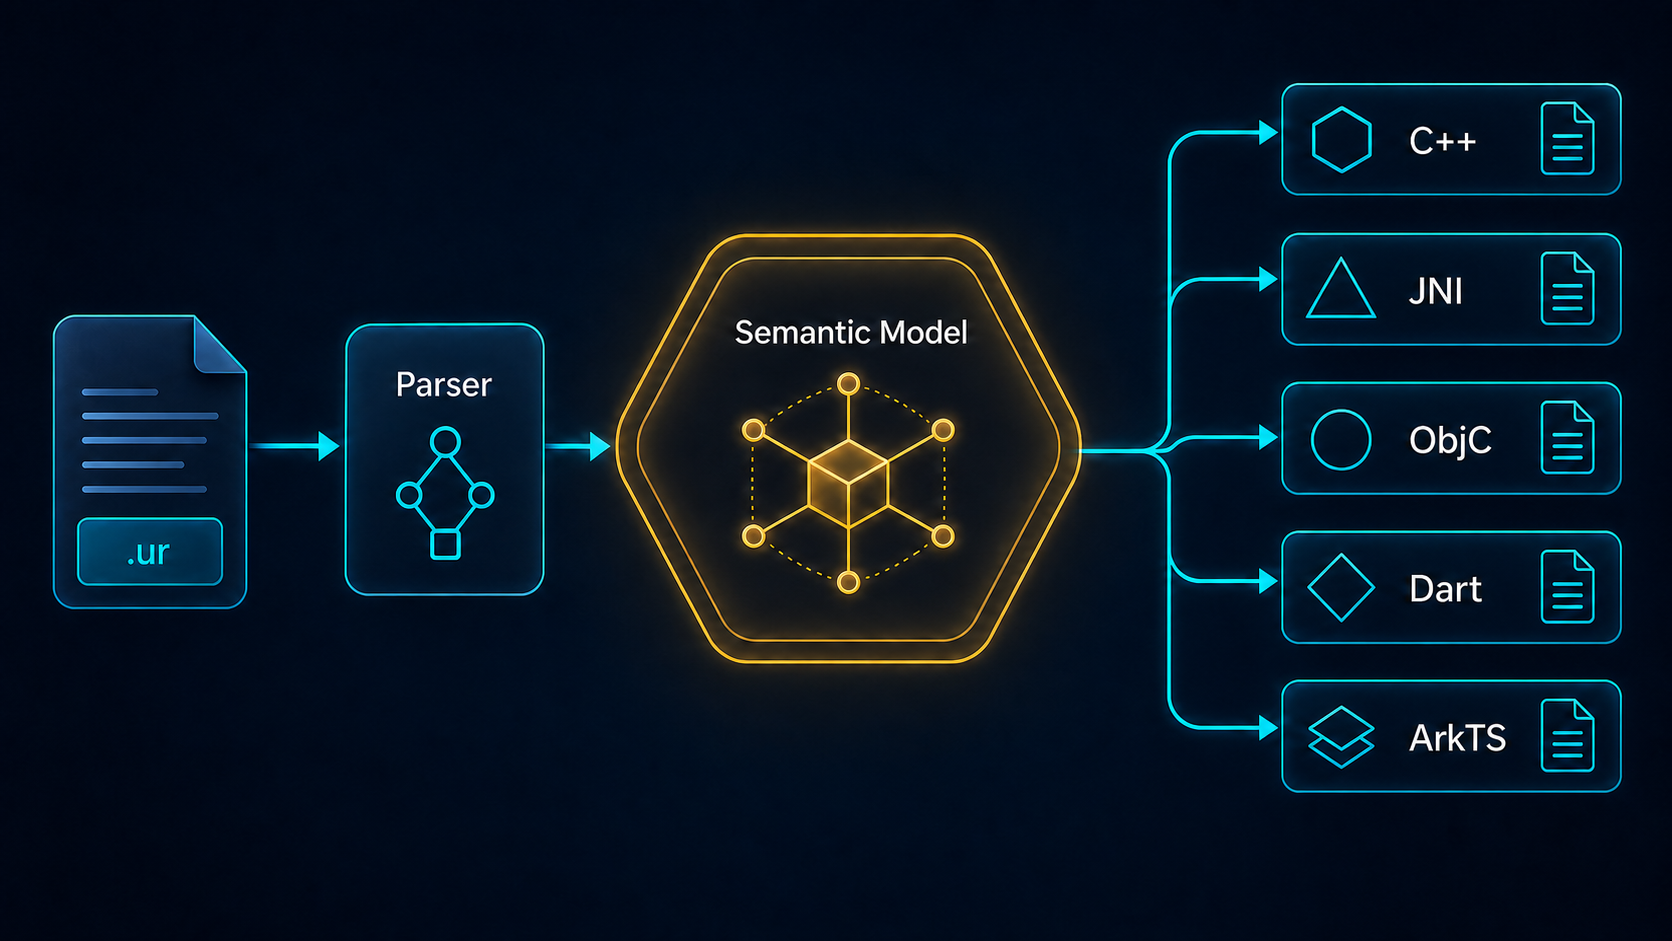
解析器只负责读懂语法;真正被各后端共同消费的是统一的语义模型。
理解这条流水线,比记住每个模板文件更重要。遇到生成错误时,首先要判断是“语法没读懂”“模型理解错了”还是“某个后端翻译错了”。
一、入口扫描:不是所有 .ur 都是独立编译单元
命令入口位于 unit_rc_gen/bin/urgen,Python 编排从 src/bin.py 的 UrBin.run() 开始。工具既可以接收明确文件,也可以扫描目录中的 .ur。
真正的生成入口需要有全局配置和模块名,例如:
@global_config {
  name = "MediaCore",
}
其他 .ur 可以通过 import 或 part 被入口文件组合进来。这样一个业务模块可以拆成多个声明文件,却只生成一套具有共同 namespace、路径和语言开关的产物。
顶层结构还包括:
@file_config:只影响当前文件;import:导入.ur或.proto;reference:引用外部已经生成的声明;part:把接口定义拆分组织;proxy_proto:根据 Protobuf message 派生代理接口。
这些结构说明生成器处理的不是单文件文本替换,而是一个有符号依赖和模块边界的声明空间。
二、Parser:BNF 决定这门语言能写什么
.ur 解析器在 src/ur_parser/parser.py。它使用 Lark 定义 BNF,并通过 Transformer 把语法树转为 UrFile、UrInterface、UrMethod、UrField 等 AST 对象。
核心声明可以简化为:
interface:
  [config] "interface" IDENT [":" parents]
  "{" (field | method | comments)* "}"

method:
  [config] [static|async|const]*
  "method" IDENT "(" variables ")" [":" output] ";"

field:
  [config] [static|async|const]*
  "field" type IDENT ["=" default] ";"
解析器的职责应该尽量纯粹:识别合法结构、保留源码位置、构造 AST。它不应该决定 int64 在 Dart 中映射成什么,也不应该直接拼接 C++ 代码。
这条边界非常重要。假如要新增 set[T]:
- Parser 先能识别新语法;
- Model 再把它建模成统一容器类型;
- 各语言后端分别决定落成
std::set、KotlinSet或 DartSet; - 转换器定义跨边界编解码;
- 模板只负责把已经整理好的信息放进文件。
只改 BNF 会得到“语法能写、生成阶段崩溃”的半成品。
三、AST 不是最终模型
AST 关心源码长什么样,模板更关心“这个声明在当前语言应该生成什么”。两者之间由 src/model/ 负责转换。
File 是统一模型入口。源码采用先注册、再实例化的思路:
第一阶段:建立符号表
先收集接口、枚举、Protobuf message 和外部引用名称。这样,即使接口 A 在文件前面引用了后面定义的 B,类型解析也能知道 B 是 interface、enum 还是 proto。
names only
  ├─ Interface: Player
  ├─ Interface: Listener
  ├─ Enum: State
  └─ Proto: TrackInfo
第二阶段:实例化语义对象
符号表建立后,再构造真正的 Interface、Method、Field 和 VariableType:
Player.prepare
  ├─ async = true
  ├─ input = TrackInfo (proto)
  ├─ output = bool
  ├─ cpp_impl = true
  ├─ dart_call = true
  └─ nullable/default rules
如果不分两阶段,前向引用、递归接口和跨文件类型都很难正确解析,模板中会充斥“如果这个名字恰好是某种类型”的补丁。
四、Config 是跨层契约,不是随手读取的字典
src/model/config.py 集中声明正式配置项、默认值和派生路径。它负责把多种写法规范化成模型和模板可以稳定消费的属性。
最关键的是 impl 和 call:
@config {
  impl = [cpp],
  call = [dart, java],
}
interface Player { ... }
Config 会把它展开为更具体的能力状态:
cpp_impl   = true
dart_call  = true
java_call  = true
objc_call  = false
arkts_call = false
...
全局、文件、接口、方法和字段上的配置需要按层级合并。越靠近声明的配置可以覆盖更上层默认值,但不能破坏未覆盖字段。
路径也由 Config 派生。例如只给出语言 binding 根目录后,可以生成 Kotlin package 目录、JNI 输出目录、Dart lib 目录和 C++ bridge 目录。模板不应再次自行拼路径,否则改一个模块结构要同时修改多个后端。
新增配置时,正确顺序是:
- 在 Config 契约中声明字段、默认值和转换;
- 确认层级合并规则;
- 让模型读取规范化属性;
- 最后才在模板里使用。
把一个未注册字符串直接塞进某个 Jinja2 模板,短期能跑,长期会形成无法追踪的隐式配置。
五、类型系统比语言类型名更重要
模型中的 VariableType 不直接保存“C++ 写法”或“Dart 写法”,而是先分类:
simple: int32 / int64 / float / double / bool / string
binary: byteArray / byteBuffer
container: list / map / set
callable: func
object: class/interface
message: protobuf message / protobuf enum
declaration: enum
同一个模型还保存:
- 是否可空;
- 容器的子类型;
- 回调的参数和返回值;
- interface/enum/proto 对应的声明;
- 用于生成唯一辅助类型的 signature;
- 当前声明继承到的配置。
比如:
list[Player?]不是一个字符串,而是 list 节点包含一个可空 class 子节点。各语言后端可以分别生成:
C++:    std::vector<std::shared_ptr<Player>>
Kotlin: Array<Player?>
Dart:   List<Player?>
ArkTS:  Array<Player | undefined>
这种统一模型让平台差异停留在后端,不污染 DSL。
空值需要独立语义
接口对象、Protobuf message 和回调天然可能为空,数值类型是否允许空值则取决于框架约定。模型通过 nullable 配置和类型后缀统一决定,再由后端映射为 nullptr、T?、_Nullable 或联合类型。
如果只在模板里看字符串后面有没有 ?,容器嵌套、默认参数和函数返回值很快就会失控。
六、模型会生成用户没有显式写出的结构
模板看到的模型并不只包含 .ur 里的接口。File 还会为一些语言能力派生辅助声明:
FuncDeclare:把匿名func[(...): ...]汇总成可复用回调类型;MapDeclare:为 map 转换生成包装与桥接;StaticRegister:处理静态方法跨模块注册;- proxy proto:从消息定义派生可调用对象;
- 异步 runner:为异步方法生成执行与完成结构。
例如两个接口都使用完全相同签名的回调,模型可以根据类型 signature 复用一个辅助类型,避免每个方法各生成一套 wrapper。
这也是排查“为什么输出里多了一个我没写的类”时应该先看模型,而不是直接删除生成文件的原因。
七、Template 后端做三件事
生成器使用 Jinja2,每条语言链通常分成三层:
config.py
  -> 文件名、启用条件、方法签名

variable_type_convert.py
  -> 统一类型映射为目标语言类型

variable_convert.py
  -> 值如何跨边界 prepare / use / release

*.j2
  -> 文件骨架与代码布局
其中变量转换最值得关注。一次参数转换不是只有“目标变量名”,而通常分成:
prepare: 创建临时引用、buffer 或 local object
name:    真正传给下一层的表达式
release: 删除 local ref、释放临时内存或归还资源
以 JNI 字符串为例,转换可能需要取得 UTF-8 指针、调用 C++ 方法,再释放 Java 字符串字符。把三段生命周期显式建模,比在模板中到处插入清理代码更不容易遗漏异常分支。
为什么 Kotlin 和 JNI 是两层后端
Android 上层希望看到自然的 Kotlin/Java API,native 边界却必须遵循 JNI 的 jobject/jstring/jlong 和签名规则。因此一条语言链会同时生成:
Kotlin interface / implementation
        │ native declaration
        ▼
JNI C++ bridge
        │ type conversion
        ▼
C++ interface / proxy
Dart 与 FFI、ArkTS 与 N-API 也有类似的“宿主 API + C ABI/运行时桥”两层结构。
八、增量生成为什么不能只看文件时间
大模块每次全量渲染所有语言产物会很慢。urgen 使用两类缓存:
.ur.lock.p:接口定义的序列化缓存;.pb.ur.lock.p:Protobuf 解析缓存。
主流程大致是:
Ur.parse(source)
  -> read cached AST info
  -> semantic equality check
  -> unchanged: skip
  -> changed: build File model
  -> render affected outputs
  -> write lock + cache
接口级变化还可以用于判断哪些模板需要重新生成。不过缓存引入了新的正确性问题:只要模型隐含规则或模板变化,输入 .ur 即使没变,也可能需要全量生成。因此工具保留关闭增量和关闭 Protobuf 缓存的选项。
排查生成异常时,一个实用顺序是:
- 使用锁定版本复现;
- 关闭增量重新生成;
- 删除“缓存误判”这个变量后,再看 parser/model/template;
- 比较产物,而不是直接修改产物。
九、.lock 锁定的是生成行为
每次生成会写入 .ur.lock,记录生成器版本、更新时间和提交信息。它的意义不是装饰性的“构建信息”,而是让历史业务可以用当时的生成器行为复现产物。
生成器升级可能改变:
- 类型映射;
- 文件结构;
- proxy 继承策略;
- 空值默认值;
- 静态注册方式;
- 模板输出细节。
如果所有模块都强制跟随最新生成器,一次升级会让整个仓库同时出现巨量产物 diff。锁版本允许模块逐步迁移,也让线上问题能回到准确版本分析。
代价是需要警惕“当前源码看起来没问题,但业务锁在旧版本”。遇到生成差异,第一项证据就应该是 .lock,而不是本机 urgen 的版本。
十、一个问题该去改哪一层
| 现象 | 优先检查 |
|---|---|
| 新语法无法解析 | ur_parser/parser.py |
| 能解析但类型识别错误 | model/variable_type.py 与符号表 |
call/impl 方向不对 | model/config.py 和语言过滤 |
| 所有语言都生成错 | 公共模型 |
| 只有 Dart 类型不对 | Dart 类型映射后端 |
| 临时引用泄漏 | 对应 variable_convert 的 release |
| 文件未更新 | 增量缓存、changed 判断 |
| 本机与业务结果不同 | .lock 版本与子仓切换 |
| 生成类缺失或多出 | 自动派生结构和 enable 条件 |
这个表背后的原则是:在最早失真的那一层修复。不要在最终模板里补 parser 的问题,也不要在运行时里容忍生成器长期输出错误语义。
十一、生成器测试应该验证语义,不只是 golden file
Golden file 能发现输出变化,却无法说明行为是否正确。比较完整的测试需要同时覆盖:
- Parser:合法/非法语法、源码位置和错误信息;
- Model:前向引用、继承、空值、默认参数和语言方向;
- Backend:每种类型在目标语言的声明和转换;
- Incremental:局部变化只更新必要文件,模板变化能强制失效;
- Integration:生成代码能编译,并完成跨语言往返调用;
- Versioning:锁定版本可复现旧产物。
特别是对象和回调,应该让每种语言轮流作为实现端,再由其他语言调用。只有 C++ 实现、其他语言调用的单向测试,无法覆盖 proxy 和反向生命周期。
十二、小结
urgen 的价值不是“写模板比手写 JNI 快”,而是把跨语言契约变成一个可检查、可生成、可复现的编译流程:
Parser 决定能写什么
Model 决定它意味着什么
Backend 决定每种语言如何表达
Runtime 决定对象真正运行时如何存活
Lock/Cache 决定结果如何复现与高效更新
下一篇将从静态生成进入动态运行,详细分析 BaseRC 如何维持对象身份,以及为什么跨语言的强弱引用不能简单等同于 shared_ptr 与 weak_ptr。