本文是 unit_rc 系列第五篇。平台桥接对照见《JNI、Objective-C、Dart 与 ArkTS 桥接对照》。通用背景可参考《Dart Native Bridge 运行时设计》。
native 回调 Dart 有两个天然限制:Dart 函数属于具体 Isolate,native 任意线程也不能像调用普通 C 函数那样随时同步进入 Dart。一个可靠的桥接运行时必须同时管理“目标是谁”和“怎样送达”。
unit_rc 把这两个问题拆为:
UnitRCDartRuntime:维护 Isolate、send port 和 Dart 注册函数;DartMessageQueue:把 C++ 回调排队,通过 Dart port 唤醒目标 Isolate;BaseMessageQueue:提供带序号、重试、超时和退出检测的公共状态机。
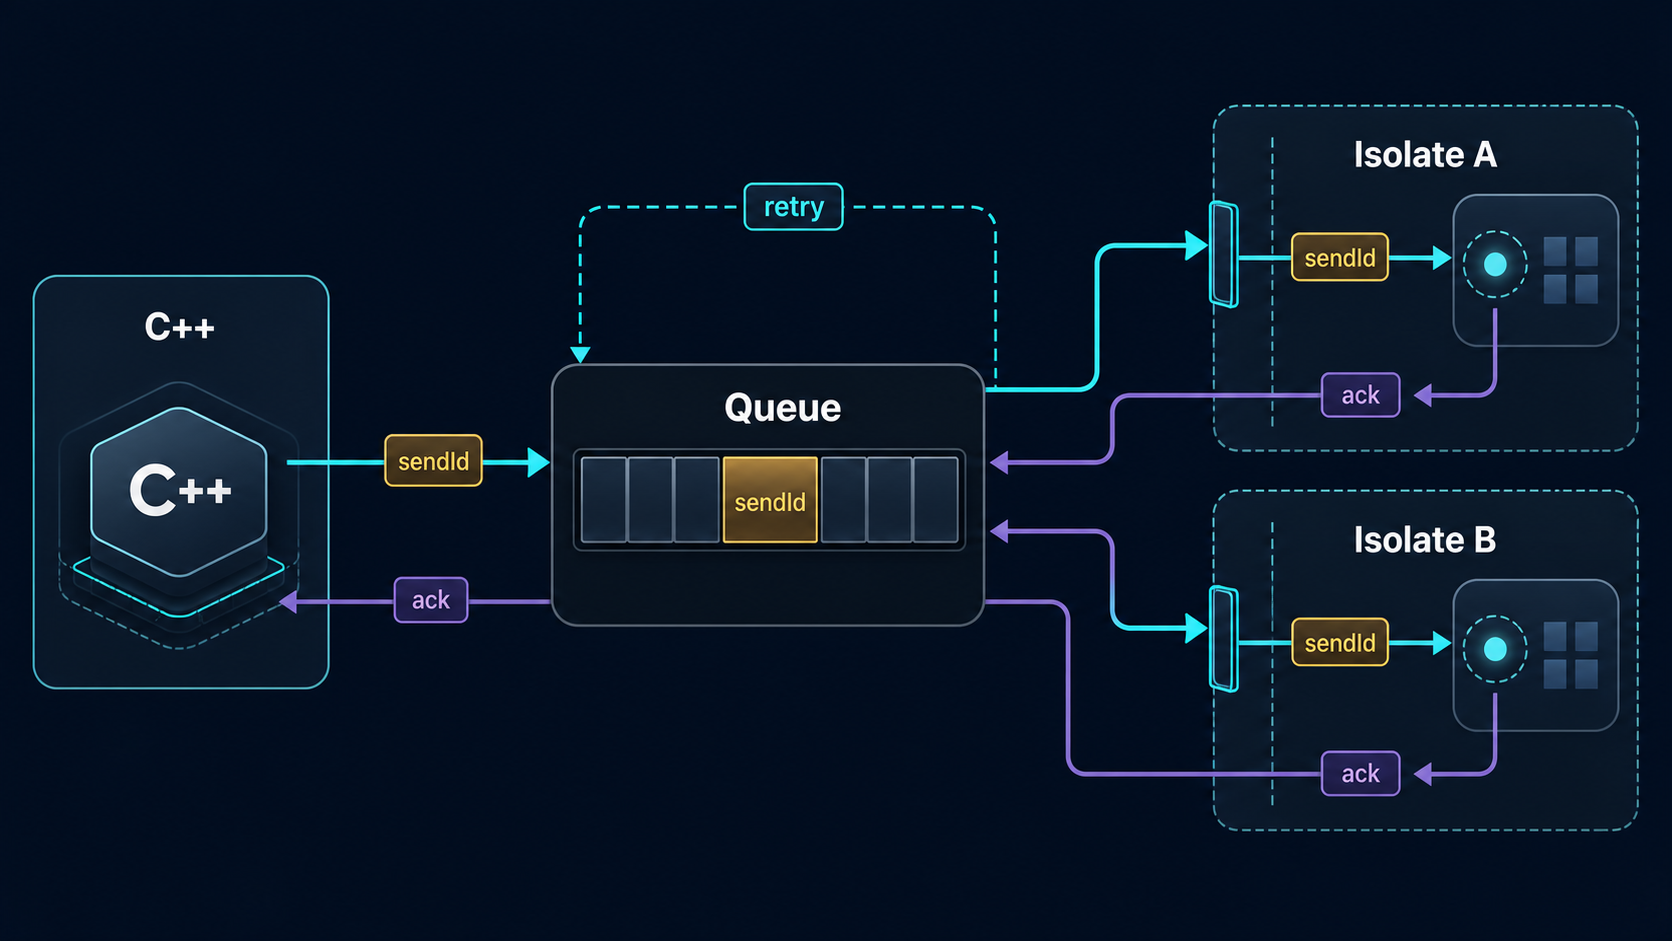
队列不只是搬运消息:它还要保存目标运行时、投递序号、确认状态和重试条件。
这篇文章沿一次 native → Dart 异步调用展开,再看队列为什么会堵、监控为什么会误判,以及当前源码的边界在哪里。
一、Dart 注册给 C++ 的函数不是进程级函数
Dart 通过 FFI 暴露给 native 的 callback,依赖创建它的 Isolate。一个全局变量:
void* dartCallback;只能在“进程永远只有一个 Isolate”的前提下成立。一旦多个 Engine 或 Isolate 并存,后注册的 callback 会覆盖前一个;旧 Isolate 销毁后,指针还可能留在 native。
当前运行时为每个 Isolate 建立 DartIsolateInfo_T:
struct DartIsolateInfo_T {
  Dart_Isolate isolate;
  Dart_Port sendPort;
  long registerTime;
  UnitRCDartFunc dartFunc;
  std::unordered_map<std::string_view,
                     std::shared_ptr<void>> dartFuncMap;
};
这里保存两类函数:
- 基础运行时统一需要的
UnitRCDartFunc; - 各生成模块注册的函数表
dartFuncMap。
全局真值是:
std::unordered_map<Dart_Isolate,
                   std::shared_ptr<DartIsolateInfo_T>> dartRegisterMap;
因此函数查找至少经过:当前 Isolate → IsolateInfo → 模块 key → 函数表。
二、注册和注销建立运行时边界
Dart 初始化时调用 native 注册入口,传入当前 send port 和基础函数表:
Dart isolate starts
   -> create ReceivePort
   -> registerDart(sendPort, funcs)
   -> create DartIsolateInfo
   -> dartRegisterMap[isolate] = info
   -> MessageQueue.register(port)
注销时执行相反操作:
Dart isolate exits
   -> unregisterDart()
   -> erase isolate context
   -> MessageQueue.unregister(port)
   -> consume/inspect pending callbacks
对象桥保存的 _isolateInfo 并不只比较裸 Isolate 值,还会通过注册表检查该 info 是否仍是当前有效项。这样,旧上下文从 map 删除后,已有 proxy 可以判断自己已经失效。
registerTime 的价值
当前结构记录注册时间,主要用于诊断:多个 Isolate 共存时,可以看到 port、Isolate 和注册先后。它也能辅助识别“同一地址是否经历了新一轮注册”。如果进一步强化运行时身份,可以加入显式 generation,避免只靠 Isolate 地址和 shared info 实例判断。
三、thread_local 只是缓存,不是身份真值
currentDartIsolateInfo() 的逻辑是:
- 调用 Dart VM API 获得当前 Isolate;
- 若 thread-local 缓存的 info 属于该 Isolate,直接返回;
- 否则加锁查询全局 map;
- 更新 thread-local 最近缓存。
thread_local DartIsolateInfo localInfo;

if (localInfo && localInfo->isolate == current) {
  return localInfo;
}

lock(mapMutex);
localInfo = dartRegisterMap[current];
return localInfo;
这比“每条线程固定对应一个 Isolate,因此所有数据都放 thread_local”更稳健。Flutter 的线程合并可能让多个 Isolate 先后使用同一平台线程,thread-local 只能做带 key 的缓存。
性能上也无需每次从头担心两层 map。生成代码可以把一个模块的多个函数聚合为结构体,再在 thread-local 中缓存最近一次 IsolateInfo 和函数表指针。只有 Isolate 切换时重新查找。
四、为什么 native 调 Dart 需要消息端口
Dart VM 允许 native 向 Dart_Port 发送消息,目标 Isolate 的 ReceivePort 收到后再执行 Dart 代码。unit_rc 在 native 侧不是直接把业务参数全部塞进 port,而是:
- C++ 把一个
std::function<void()>放入对应 port 的队列; - 通过
Dart_PostInteger发送sendId; - Dart 收到整数后,通过 FFI 调回
consume(sendId); - C++ 取出这一批函数并执行;
- 这些函数此时处于目标 Dart Isolate 的调用上下文,可以安全进入生成的 Dart callback。
Native worker
   │ queue(callback)
   ▼
C++ MessageQueue[port]
   │ Dart_PostInteger(port, sendId)
   ▼
Dart ReceivePort
   │ FFI consume(sendId)
   ▼
C++ swaps pending callbacks
   │ execute on Dart context
   ▼
generated Dart function
port 消息只承担“唤醒和确认”,真实任务仍保存在 native。这避免把复杂 C++ 闭包序列化为 Dart 消息,也让多条任务可以批量消费。
五、MessageQueueInfo 是一个状态机
每个 port 对应一份状态:
struct MessageQueueInfo {
  MessageQueuePort port;
  std::vector<std::function<void()>> funcList;
  bool inNotify;
  bool inRetry;
  bool inTimeout;
  bool inExit;
  size_t retryCount;
  int64_t sendId;
  uint64_t sendMs;
  int64_t preferId;
};
可以把正常流程画成:
Idle
  │ first callback
  ▼
Notify(sendId = n)
  │ post success, inNotify = true
  ▼
Waiting Dart
  │ consume(n)
  ▼
swap funcList, preferId = n + 1
  │ execute callbacks outside lock
  ▼
Idle
inNotify 防止每个新任务都向 Dart 再发一次唤醒。等待期间新任务只追加到 funcList,本次 consume 会把积累任务一起取走。
回调在锁外执行也非常关键:任务内部可能继续 queue、新增对象或触发跨语言调用。如果持有队列锁执行,极易形成重入死锁或把生产者长时间阻塞。
六、为什么只有 inNotify 会永久堵塞
最简单的实现是:通知成功后设置 inNotify=true,只有 Dart consume 才恢复 false。但只要通知链在某一步异常,队列就永远认为“已经通知过”:
C++ queues callback
   -> Dart_PostInteger returns success
   -> message never reaches Dart / runtime pauses / callback chain breaks
   -> inNotify remains true
   -> later callbacks no longer notify
   -> queue grows forever
unit_rc 使用积压驱动重试:
- 待执行任务超过 30 条,进入 retry;
- retry 阶段每多 20 条任务,允许再次通知;
- 超过 90 条,上报 MessageQueue 错误;
- 可丢弃的任务在高积压时直接拒绝,保护关键任务。
这些数值是当前实现的策略参数,不是普遍最佳值。它们表达的设计思想是:没有额外定时线程时,利用后续生产活动检测队列长时间未被消费,并打破 inNotify 的永久等待。
积压驱动的局限
如果队列只有一条关键任务,后续再也没有新任务,靠队列长度就不会触发重试。当前实现另有 consume(sendId=0) 的主动检查路径,用发送时间判断超时,但它仍需要某个调用触发检查。
更严格的系统可以使用计时器或统一 watchdog,在超过 deadline 后主动重发。但要防止后台暂停期间产生无意义的通知风暴。
七、sendId 与 preferId 怎样检测消息丢失
每次通知前 sendId += 1。Dart 收到后把同一个 ID 回传,native 维护期望值 preferId:
send 1 -> receive 1 -> prefer 2
send 2 -> receive 2 -> prefer 3
send 3 -> receive 5 -> report lost 3..4
源码在 sendId != preferId 时上报 ErrorTypeMessageLose,并把 preferId 更新为 sendId + 1。
序号不能证明业务 callback 一定成功,只能证明唤醒/消费链的顺序。callback 自己抛错、提前返回或目标对象失效,需要在更上层记录。但没有序号时,连“通知有没有跳号”都无法判断。
八、超时和“超时回来”是两个事件
当主动检查发现:
inNotify == true
and currentTime - sendMs > 5s
队列会:
- 记录 timeout 信息;
- 清除
inNotify,允许重新通知; - 设置
inTimeout=true。
如果原消息后来仍被 Dart 收到,consume(sendId) 会进入“timeout back”分支,移除相应 timeout 记录并恢复状态。
这很符合移动端现实:应用进入后台后,Dart 线程可能被暂停,native 消息在前台恢复后才消费。超过 5 秒不必然等于丢失。
因此监控至少区分:
timeout:      迟迟未确认
timeout back: 曾超时但最终确认
lose:         序号不匹配或退出仍未确认
notify fail:  Dart_PostInteger 明确失败
把所有 timeout 都算成消息丢失,会让后台恢复产生大量脏数据,真正的异常反而被淹没。
九、TimeoutManager 的延迟确认
MessageQueueTimeoutManager 会暂存超时项。后续检查时,超过第二个时间窗口仍未被 remove(sendId) 的项目才正式上报。
first 5s threshold
   -> mark timeout, allow retry

next check / grace period
   -> ack arrived: remove
   -> still pending: report timeout
这种延迟确认减少了短暂调度暂停带来的误报。需要注意,当前容器使用无序 map,而检查逻辑看起来按遍历顺序遇到未超时项就停止;若依赖严格时间顺序,应使用按 deadline 排序的结构或扫描全部项目。这类细节说明“有 timeout 管理器”不等于监控已经天然精确,状态容器和遍历假设同样需要测试。
十、退出时不能直接丢掉队列
注销 port 时,运行时先设置 inExit,拒绝新任务,再调用内部 consume/清理:
- 尽可能执行或取走已有任务;
- 若仍处于 timeout,报告未确认消息;
- flush timeout manager;
- 如果还有未执行函数,上报
noexe类消息丢失; - 最后从
_queueMap删除 port。
Active
  -> inExit = true
  -> reject new callbacks
  -> drain/check pending
  -> report unresolved state
  -> erase port
退出时机要靠近 Isolate 真正结束。如果业务在一个较早的 Engine 生命周期回调就注销,而 Dart 线程后面仍可能消费,会把可送达消息提前判成丢失;反过来注销太晚,native 又可能向已经无效的 port 投递。
十一、锁和重入
队列使用 recursive_mutex,因为注销过程中会调用内部 consume,某些流程存在同线程嵌套。recursive mutex 可以简化有限的内部重入,但不能解决跨线程锁环。
这里有两个值得保留的原则:
- 锁内只修改 queue 状态、swap 容器;
- 真正执行业务 callback 必须在锁外。
通知 notifyImpl() 当前在锁内调用。对 Dart 它只是 Dart_PostInteger,通常很短;若未来某个平台 notify 可能同步回调或阻塞,就需要重新评估锁边界,避免宿主重入 consumeImpl()。
十二、当前实现可以怎样继续演进
结合源码,进一步增强可靠性可以考虑:
显式 Context Generation
IsolateInfo 增加不可复用的 generation,缓存和消息同时携带,彻底区分同地址的新一轮注册。
基于 deadline 的 watchdog
不依赖后续生产者数量,少量关键任务也能在 deadline 后触发检查;后台时暂停或放宽策略。
单调时钟
超时使用 steady_clock 而非墙上时间,避免系统时间调整影响间隔计算。
有序 timeout 容器
如果检查逻辑希望从最早 deadline 开始停止,应使用 deque、heap 或 ordered map,避免无序容器迭代顺序假设。
明确 ack 语义
区分“Dart 收到通知”“C++ 取走 callback”“callback 执行完成”。对要求 exactly-once 结果的任务,仅有唤醒 ack 不够,还需任务级完成协议。
退出取消回调
未执行任务不只是上报丢失,还应根据接口语义给调用者返回 cancelled/runtime-exited,避免 Future 永久等待。
十三、排查清单
- Dart callback 是否注册在当前 Isolate 的函数表?
- thread-local 缓存是否比较了当前 Isolate?
- proxy 保存的
_isolateInfo是否还在注册表中? - port 是否已注册、是否进入
inExit? inNotify/sendId/preferId/sendMs当前是什么状态?- 队列是否达到 retry 和高水位?
Dart_PostInteger返回了什么?- timeout 后是否出现匹配的 timeout back?
- 应用当时是否在后台或发生 Engine 退出?
- 注销时还有多少 callback 与 timeout 项?
十四、小结
多 Isolate 与消息可靠性其实是一件事的两面:每条消息不仅要“送到 Dart”,还必须送到正确、仍然存活的 Dart 上下文。
unit_rc 当前实现用:
Isolate map + thread-local keyed cache
    -> 解决目标身份

port + native callback queue
    -> 解决跨线程投递

sendId/preferId + retry/timeout/exit
    -> 解决可观测可靠性
下一篇将完成系列的另一条关键链路:复杂数据怎样通过 ByteBuffer 和 Protobuf 跨语言传输,以及性能 profile 与统一错误如何让框架具备线上演进能力。