本文是 unit_rc 系列第六篇。异步运行时见《多 Isolate 注册表与跨运行时消息队列》。更完整的性能实验见《跨语言传递 Protobuf:从拷贝路径到所有权模型》。
跨语言框架的对象模型解决了“谁在调用谁”,数据通道还要解决“参数怎样过去”。基础数值可以直接按 ABI 传递,字符串、容器和 Protobuf 则会涉及分配、复制、编码、宿主对象包装和释放。
unit_rc 运行时提供 ByteBuffer 作为统一二进制对象,并在 Dart、Java、Objective-C、ArkTS 各端使用宿主的直接内存能力。与此同时,它用 BaseProfile 采集生成调用的耗时,用 UnitRCError 统一记录引用、转换、proxy 和消息问题。
这三部分应该一起看。零拷贝如果没有所有权协议,会变成 use-after-free;性能优化如果没有端到端 profile,只会数 memcpy;运行时如果只打印平台日志,线上无法比较不同语言链路。
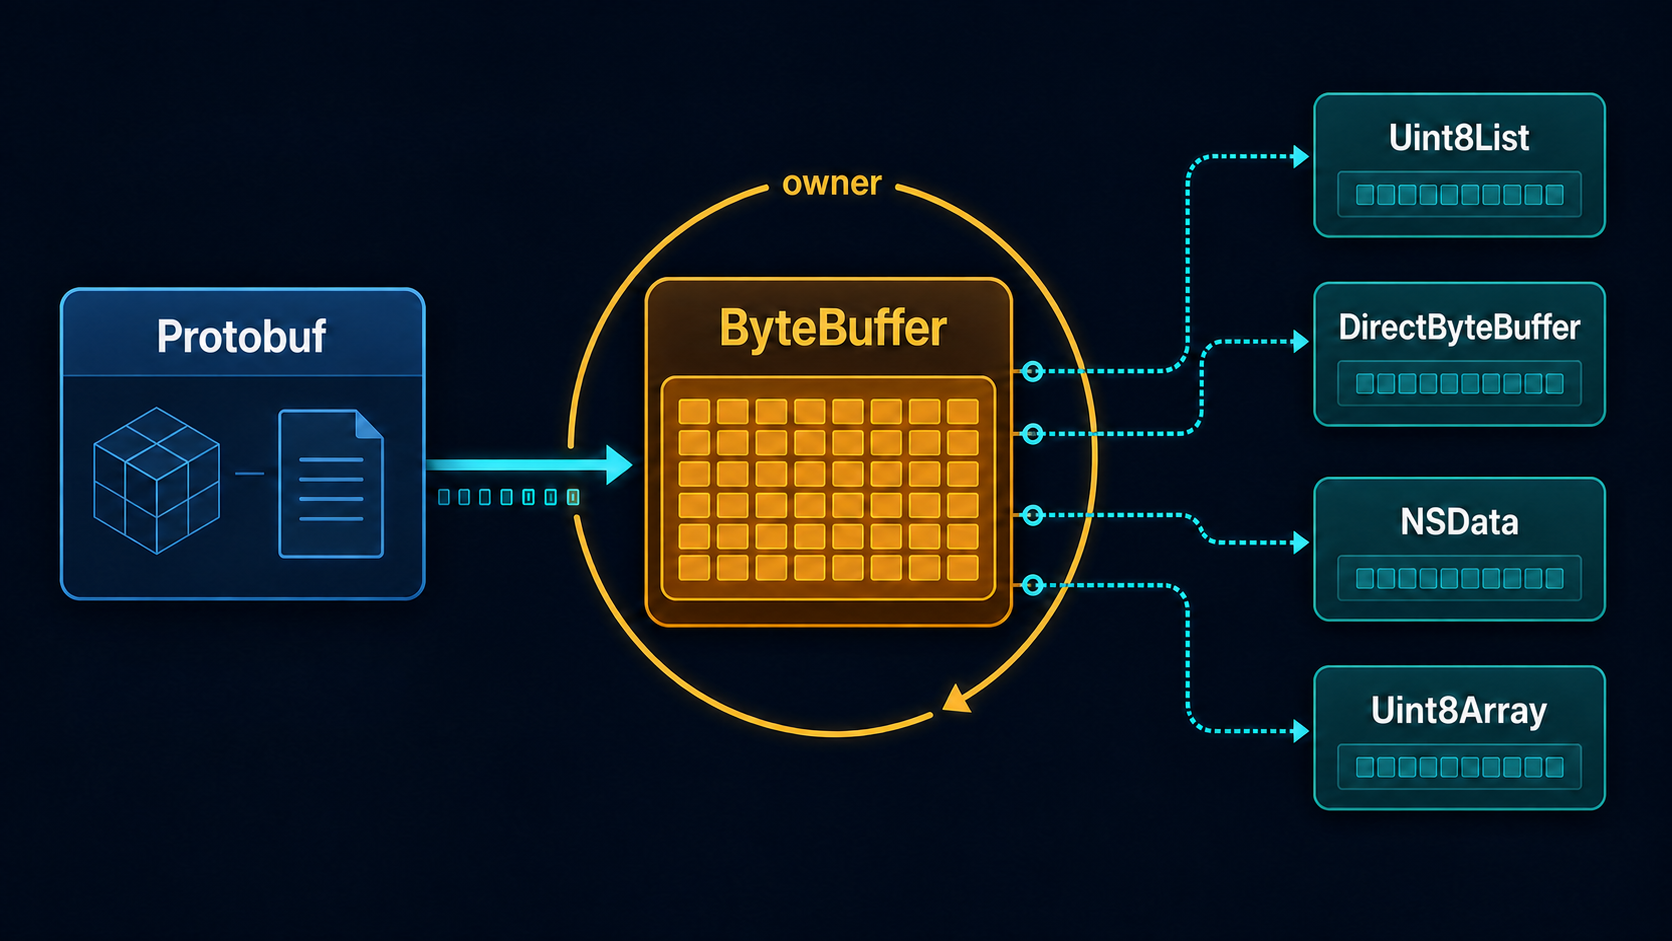
减少拷贝的关键不是换一个容器名称,而是让多个宿主视图共享同一块 buffer,并把 owner 的生命周期说清楚。
一、ByteBuffer 的公共模型非常小
unit_rc/base/UnitRCByteBuffer.h 的核心只有:
class ByteBuffer : virtual public BaseRC {
 public:
  uint8_t* data = nullptr;
  size_t length = 0;
};
C++ 默认实现 ByteBufferCpp 按 length 分配一块连续内存,析构时 free。它仍然继承 BaseRC,因此可以复用对象 identity、强弱引用和各平台 wrapper。
同时提供 Protobuf 辅助:
template<class T>
static std::shared_ptr<ByteBuffer> fromMessage(
    const std::shared_ptr<T>& value) {
  auto length = value->ByteSize();
  auto buffer = ByteBuffer::create(length);
  value->SerializeToArray(buffer->data, length);
  return buffer;
}

template<class T>
static std::shared_ptr<T> toMessage(
    const std::shared_ptr<ByteBuffer>& value) {
  auto result = std::make_shared<T>();
  result->ParseFromArray(value->data, value->length);
  return result;
}
这层只定义“连续字节 + 长度”和编码入口,不定义业务协议。消息 schema 仍由 .proto 和生成器负责。
二、同一块内存在四个平台怎样呈现
Dart:native 指针映射为 typed data
Dart ByteBuffer wrapper 保存 native data pointer 和 length。Dart → C++ 时,运行时从 handle 附加信息中取得地址;C++ → Dart 时,生成的 Dart 函数根据地址与长度创建可访问的 typed list wrapper。
关键不变量是:Dart wrapper 存活期间,拥有内存的 BaseRC 不能析构。attach 的强弱关系不是附带功能,而是 no-copy 成立的前提。
Java:DirectByteBuffer
Java → C++:
GetDirectBufferCapacity(buffer)
GetDirectBufferAddress(buffer)
C++ → Java:
NewDirectByteBuffer(data, length)这避免把数据复制进 byte[],但只适用于真正的 direct buffer。Java 上层如果最终又调用 get(byte[]) 才能给 Protobuf 解析,端到端仍会复制一次。
Objective-C:NSData no-copy
Objective-C → C++ 直接读取 NSData.bytes 和 length;C++ → Objective-C 使用:
[NSData dataWithBytesNoCopy:data
                     length:length
               freeWhenDone:NO]
freeWhenDone:NO 表示 NSData 不负责内存释放,因此 BaseRC 必须维持 owner 生命周期。
ArkTS:External ArrayBuffer + Uint8Array
C++ → ArkTS 使用 napi_create_external_arraybuffer 包装 native 内存,再创建 napi_uint8_array。反方向用 napi_get_typedarray_info 取得 data、length 和 offset。
external array buffer 的 finalizer 在当前实现里不直接释放数据,因为内存由 ByteBuffer/BaseRC 管理。finalizer 与 wrapper detach 仍需确保引用闭环最终被打破。
三、ByteBuffer 是对象,性能也会付对象成本
ByteBuffer 复用 BaseRC 带来统一生命周期,却也意味着每次传输可能涉及:
- 创建 C++ 对象和
shared_ptr; - 分配
rcId; - 创建宿主 wrapper;
- attach strong/weak reference;
- 写入 identity;
- 加入/查询对象注册;
- finalizer 和 detach;
- 多 runtime 检查。
如果 buffer 只为了在一次同步调用中把 1 KB Protobuf 交给目标解析器,这些固定成本可能比一次 memcpy 更高。
因此要区分两种数据抽象:
General ByteBuffer object
  - can be stored
  - can cross async boundary
  - identity + reference protocol
  - heavier

Borrowed/raw buffer
  - valid only during call
  - cannot be retained
  - pointer + length
  - lighter
通用对象适合长期共享、异步和多次往返;Protobuf 的即时传输更可能适合作用域受控的 raw buffer。生成器能够保证“解析在返回前完成”时,才有资格选择 borrowed 路径。
四、零拷贝的真实条件
想声称某条链路零拷贝,至少要同时满足:
- 源编码器可以直接写入目标内存,或已有数据本身就在可共享内存;
- 桥接 API 能暴露同一地址;
- 目标解析器接受 pointer/ByteBuffer,而不是强制转换到另一容器;
- 数据在消费完成前不会被释放或复用;
- wrapper、引用和 finalizer 的固定成本低于被省掉的复制。
以 Java 为例,C++ NewDirectByteBuffer 确实不复制;但如果 Java Protobuf API 只接受 byte[],下一步仍然复制。此时只能说“C++ 到 DirectByteBuffer 这一步 no-copy”,不能说端到端零拷贝。
以 Objective-C 为例,NSData no-copy 能让消费者直接读 C++ 地址;若业务把 NSData 长期保存,而 C++ ByteBuffer 提前析构,就会用到无效内存。性能正确性必须由对象协议保证。
五、Protobuf 的两种抽象层级
.ur 可以导入 .proto,生成器识别 message/enum,并为各语言生成自然类型和跨边界转换。通常有两种实现思路:
5.1 传序列化数据
source protobuf object
  -> serialize into buffer
  -> cross boundary
  -> parse target protobuf object
优点是各端保持原生 Protobuf API,协议稳定,调用结束后互不共享状态。成本是每次编码与解析。
5.2 生成 Proto Proxy
把 message 暴露为跨语言 interface,字段访问通过 proxy 回到真实对象。优点是无需每次完整编解码,适合少量字段读取或大对象延迟访问。缺点是:
- 每次 getter 都是跨语言调用;
- 对象生命周期更复杂;
- 批量遍历字段可能比一次解析慢得多;
- schema 演进和可写字段需要额外契约。
选择标准不是“proxy 更高级”,而是访问模式:
读取绝大多数字段、跨边界后本地频繁使用
  -> 序列化后本地解析通常更合适

对象很大、只读取少量字段、需要共享实时状态
  -> proxy 可能更合适
六、SharedMemoryInt64 展示了另一种取舍
运行时中还有一个较新的 SharedMemoryBase/SharedMemoryInt64 实现。它用一块 ByteBuffer 保存:
1 byte current index
+ N slots × fixed-size data
写入时选择下一个 slot,把值以固定字节序写入,再更新 index;读取时先取 index,再从对应 slot 解码。它更像一个小型多版本缓存:读者持有上次 index 时,写者切换到另一个 slot,降低正在读取的数据被原地覆盖的概率。
index | slot 0 | slot 1 | slot 2
  1   | old    | current| next
这个实现提供了很有价值的思路,但不能自动等同于通用无锁共享内存:
- index 的读写是否具有目标平台所需的原子与内存序;
- 写完 slot 与发布 index 之间是否有可见性保证;
- 多写者是否会竞争;
- cacheSize 和 index 边界是否严格正确;
- 运行时进程/线程模型是否允许同一物理内存直接共享。
所以把它写成文章时更适合作为“固定大小数据的实验性共享布局”,而不是已经验证的通用 lock-free 容器。
七、BaseProfile 怎样测跨语言调用
BaseProfileScoped 由生成代码通过宏放到调用作用域:
UR_PROFILE(module, language, interface, method)构造时记录开始时间,析构时记录结束时间并加入全局 profile 缓冲。每项包含:
- 模块;
- 语言链路;
- interface;
- method;
- duration;
- 时间戳/辅助字段。
缓存达到数量、时间间隔或最大容量条件后,运行时把数据交换出来,异步聚合:
(module, language, interface, method)
   -> total duration / count
   -> average + count
   -> split report strings
   -> application callback
这样不会每次调用都直接触发上报 SDK,避免监控本身淹没被测调用。业务通过 ProfileConfig 配置采样/批量参数和回调。
平均值不够
当前聚合主要记录平均耗时与次数,适合发现高频方法的总体成本。对于尾部延迟,还应考虑直方图或分位数近似,否则少量极慢调用会被平均值稀释。
还要明确 profile 范围:生成 proxy 方法的 RAII 计时,是只覆盖桥接转换,还是包含目标业务实现?不同方向模板放置宏的位置会影响数字含义。监控文档应说明测量边界。
八、性能监控必须避免反向放大问题
跨语言调用可能非常高频。如果每次都分配字符串、取锁和打印日志,profile 会改变真实性能。当前实现采用:
- 指针形式保存静态 module/interface/method 名称;
- 批量 vector;
- 达到阈值后 swap;
- 后台聚合与分段上报;
- 可全局关闭。
继续优化时可以关注:
- 多线程写同一 vector 的锁竞争;
- 上报阈值改变后已分配缓存的容量;
system_clock与steady_clock的选择;- 字符串 key 拼接的聚合成本;
- 回调执行失败后的数据处理;
- 监控数据是否包含内部模块或敏感方法名。
公开文章和外部日志可以使用稳定哈希或抽象模块名,避免暴露内部业务结构。
九、UnitRCError 是运行时的结构化异常通道
UnitRCError 定义语言维度:
Cpp / Java / ObjC / Dart / ArkTs
CppJava / CppObjc / CppDart / CppArkTs
以及错误类型:
sharedThis
attach/detach strong/weak
from/to conversion
message queue / lose / notify / timeout
duplicate export
create proxy
UR_REPORT_ERROR 会先写日志,再调用全局 reportError();应用通过生成接口注册 callback,把结构化错误接入自己的上报体系。
这种设计让 runtime 不依赖具体监控 SDK,同时保证所有平台问题进入同一分类。分析时可以回答:
- 哪条语言链更容易发生转换错误?
- 弱引用 attach/detach 是否在特定版本突增?
- 多 Isolate 改造后 timeout 与 lose 如何变化?
- 某个接口的 proxy 创建失败是否集中在继承回退?
十、错误 message 应该是诊断码,不是业务数据
源码中不少 message 使用短码和数字组合,例如 sendId、port、期望序号。这种形式不够易读,却有两个优点:成本低、不会直接记录方法参数。
更可维护的折中是定义稳定的结构化字段:
error_type=create_proxy
language=dart
reason=creator_missing
runtime_valid=true
type_id=<stable hash>
object_state=proxy
不要上报:
- 原始字符串参数;
- Protobuf 内容;
- 用户 ID;
- 完整对象地址;
- 内部域名或日志链接。
对象地址可以在本地 debug 日志使用,线上应转为进程内随机/哈希 identity,避免既无跨会话意义又带来信息风险。
十一、把性能与错误关联起来
单独看 profile 只能知道慢,单独看 error 只能知道失败。更成熟的观测可以共享一次调用的轻量 trace ID:
call start
  -> trace_id, language, interface, method
  -> conversion duration
  -> queue wait duration
  -> target execution duration
  -> return conversion duration
  -> error/cancel if any
不需要全量记录。对高频调用采样,对错误调用强制保留,就能区分:
- 慢在序列化还是消息队列;
- timeout 时目标 runtime 是否正处于退出;
- create proxy 失败前是否发生类型回退;
- 大 buffer 是否与 GC/内存峰值相关。
十二、数据通道的选择清单
基础值/短字符串
直接 ABI/JNI/FFI 转换,避免为小值创建 BaseRC 对象。
小型 Protobuf
序列化为普通 byte array 往往最简单;一次复制可能比通用 ByteBuffer 对象绑定更便宜。
大型 Protobuf
测量 direct/external buffer 的阈值;确认目标解析器可直接消费,且 owner 跨异步边界安全。
大对象少量字段
考虑 proto proxy,但必须测量跨语言 getter 次数,避免 N 个字段变成 N 次桥接。
长期共享二进制
使用完整 ByteBuffer/BaseRC 引用协议,明确只读/可写与释放端。
高频固定大小状态
可以探索共享布局或多槽缓存,但先证明内存序、并发模型和宿主支持,不要把实验代码直接宣称为 lock-free。
十三、系列总结
从第一篇到这里,unit_rc 的完整链路已经串起来:
.ur declaration
    │
    ▼
urgen parser -> model -> language templates
    │
    ▼
generated interface / proxy / conversion code
    │
    ▼
BaseRC identity + cross-language reference protocol
    │
    ├─ JNI / ObjC / Dart / ArkTS bridges
    ├─ Isolate context + MessageQueue
    ├─ ByteBuffer / Protobuf data path
    └─ Profile + Error observability
这套工程最值得复用的并不是某个宏或模板,而是分层方式:
- DSL 只描述跨语言契约;
- 模型把语义标准化;
- 后端处理语言表达;
- C++ 运行时维护共同身份;
- 平台桥尊重宿主限制;
- 消息和数据路径都有明确所有权;
- 失败与耗时被纳入框架能力。
跨语言调用永远不可能真的“和本地调用一模一样”。好的框架不是掩盖所有差异,而是把差异放到正确层级,让业务在安全契约内获得接近本地调用的体验,同时让维护者仍能沿源码还原每一次对象、消息和字节的流向。